Come tutti gli informatici o gli appassionati di questa materia, ho accumulato nel tempo un numero impressionante di componenti come CPU, memorie, dischi, case, alimentatori e schede di ogni tipo.
Tutto ciò che ha più di 10 anni viene considerato obsoleto, tuttavia, questi componenti sono ancora perfettamente funzionanti e in grado di far girare quasi qualunque cosa dignitosamente. Vale anche per i modelli AI? Decisamente no!
Ma c’è una scappatoia: quello che serve è la GPU, l’LLM gira esclusivamente lì. Il resto della macchina non ha bisogno di chissà quale sofisticazione.
Il piano#
L’idea è quindi semplice: possiamo riutilizzare vecchi componenti che potremmo già possedere e concentrare la spesa nella GPU. In questo modo possiamo permetterci un’AI personale senza spendere una follia.
In realtà anche la GPU potrebbe essere di seconda mano. Si può leggere un po’ ovunque che la RTX 3090 di NVidia è ancora una scelta eccellente, ma mantiene prezzi elevatissimi (ad oggi ~1000€) così come i suoi consumi di corrente. Inoltre, una singola 3090 potrebbe essere stretta con i suoi 24GB di VRAM.
Non esiste solo NVidia, ma con essa si semplifica il processo: tutti i software, specialmente quelli per machine learning, inferenza e tutto ciò che serve per l’AI locale hanno il massimo supporto se l’hardware è NVidia in quanto utilizzano le librerie proprietarie CUDA.
Requisiti e scelte#
Per costruire la mia macchina di inferenza locale bisogna definire quelli che per me sono i requisiti minimi per far girare un modello sufficientemente capace per i miei utilizzi.
Il 14 agosto 2026 sono stati pubblicati i pesi di Qwen3.8-27B che con la stessa dimensione della precedente versione 3.6 ha ulteriormente migliorato le prestazioni ed è ancora imbattuto fra i modelli di pari dimensione, almeno secondo il mio personale parere. Qwen3.8-27B è dunque il modello che ho scelto per l’inferenza locale.
Ospitare un LLM da 27B significa occupare ~18-23GB di VRAM sulla GPU a seconda della quantizzazione adottata (int4, fp4). Poi bisogna sommare la dimensione della KV cache che volendo supportare l’intera finestra di contesto nativa (262K token) ammonta a ~8 GiB = 8.6 GB. Ne segue che 32GB di VRAM sono il requisito minimo.
Il problema è che l’unico prodotto consumer di NVidia con 32GB è la RTX 5090 che oltre che essere introvabile, ha un prezzo proibitivo che non sto neppure a riportare. Ho scelto quindi di ripiegare su una configurazione a doppia GPU con 2 schede RTX 5060 Ti da 16GB ciascuna da usare in parallelo (’tensor parallel’). Vedremo in seguito che ci sono sia vantaggi che svantaggi in questa configurazione. Tuttavia la considero il compromesso migliore nel rapporto prestazioni e consumi (TDP 180W e 3W in idle) ed essendo di generazione ‘Blackwell’ supporta nativamente la quantizzazione NVFP4. Vi rimando alla documentazione di NVidia per apprezzare le differenze fra le varie codifiche in virgola mobile a 4-bit.
La configurazione finale#
Il PC che ho utilizzato era stato creato inizialmente come PC da gaming, ma visto l’utilizzo o forse dovrei dire il non utilizzo, l’ho destinato all’inferenza locale.
La configurazione ed i costi sono riassunti in tabella.
| Componente | Modello | Già in possesso | Costo (€) |
|---|---|---|---|
| CPU | Intel Core i7-3770 | ✅ | 0 |
| CPU cooler | Thermalright sl-100 | ✅ | 0 |
| Main Board | Gigabyte GA-Z77X-UD3H | ❌ | 79 |
| RAM | 32GB DDR3 (4x8GB) | ✅ | 0 |
| SSD | Samsung 860 EVO mSATA 500GB | ✅ | 0 |
| PSU | be quiet! Pure Power 12M 650W | ✅ | 0 |
| Case | very old Cooler Master case | ✅ | 0 |
| GPU (x2) | Asus DUAL RTX 5060 Ti OC | ❌ | 580*2 |
Il costo per rendere adeguato il PC all’inferenza è stato di 1239€.
Il prezzo è simile o inferiore ad una soluzione a singola scheda
AMD o Intel con tutte le complicazioni del caso.
Ho preferito cambiare scheda madre ed utilizzarne una (GA-Z77X-UD3H) che
potesse allocare 8 lane per entrambi i connettori PCIe 16x. Si tratta
di PCIe 3.0 invece del 5.0 supportato dalla RTX 5060.
È tanto? È poco? Dipende. Giustificare una spesa è una funzione di molti parametri il cui peso è dato dalle situazioni personali. Nel mio caso, questa spesa è senza alcun ritorno economico: per passione ed interesse personale e ritengo che sia la spesa minima possibile.
Consumi#
Per un server all’interno di un home lab il consumo in idle assume un’importanza rilevante: la maggior parte del tempo infatti la macchina non è impegnata.
Per quanto non si parli di software in questo post, è importante sapere che questa macchina usa Proxmox. I consumi sono stati misurati avendo attivi:
- 1 container LXC (Debian GNU/Linux 13 trixie) per il motore di inferenza con accesso alle GPU
- 1 VM Linux Ubuntu 26.04.1 LTS per l’ambiente degli agenti (Hermes)
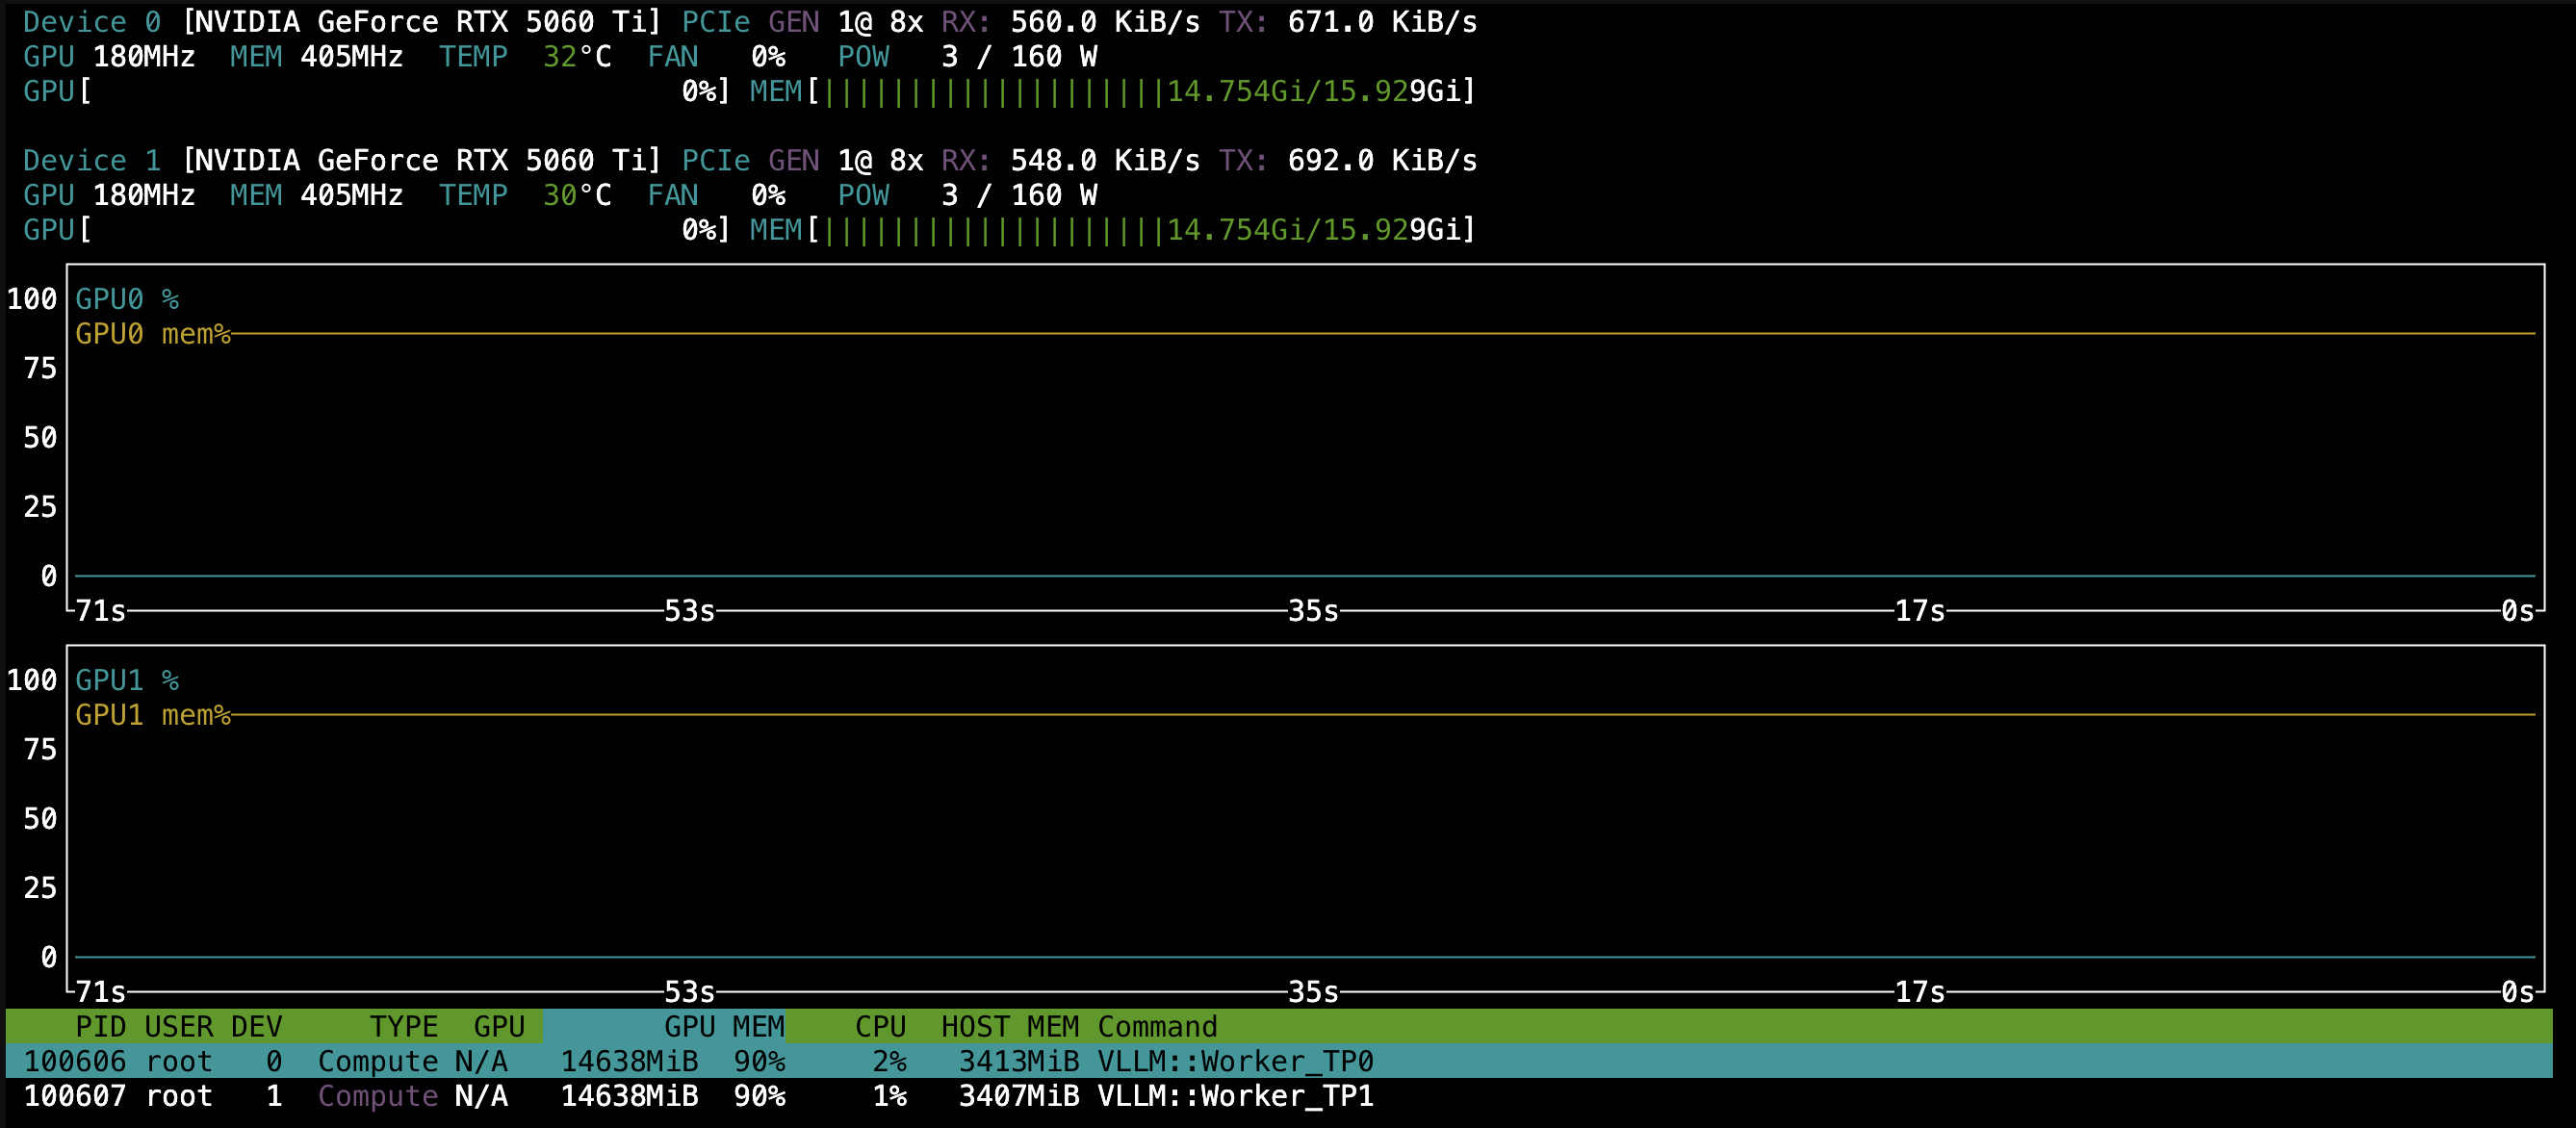
Sopra: Consumo a riposo RTX 5060 Ti.
Con ’nvtop’ il consumo delle 5060 Ti risulta molto basso: 3W per GPU. Il consumo massimo è stato limitato a 160W (vs. 180W nativi).
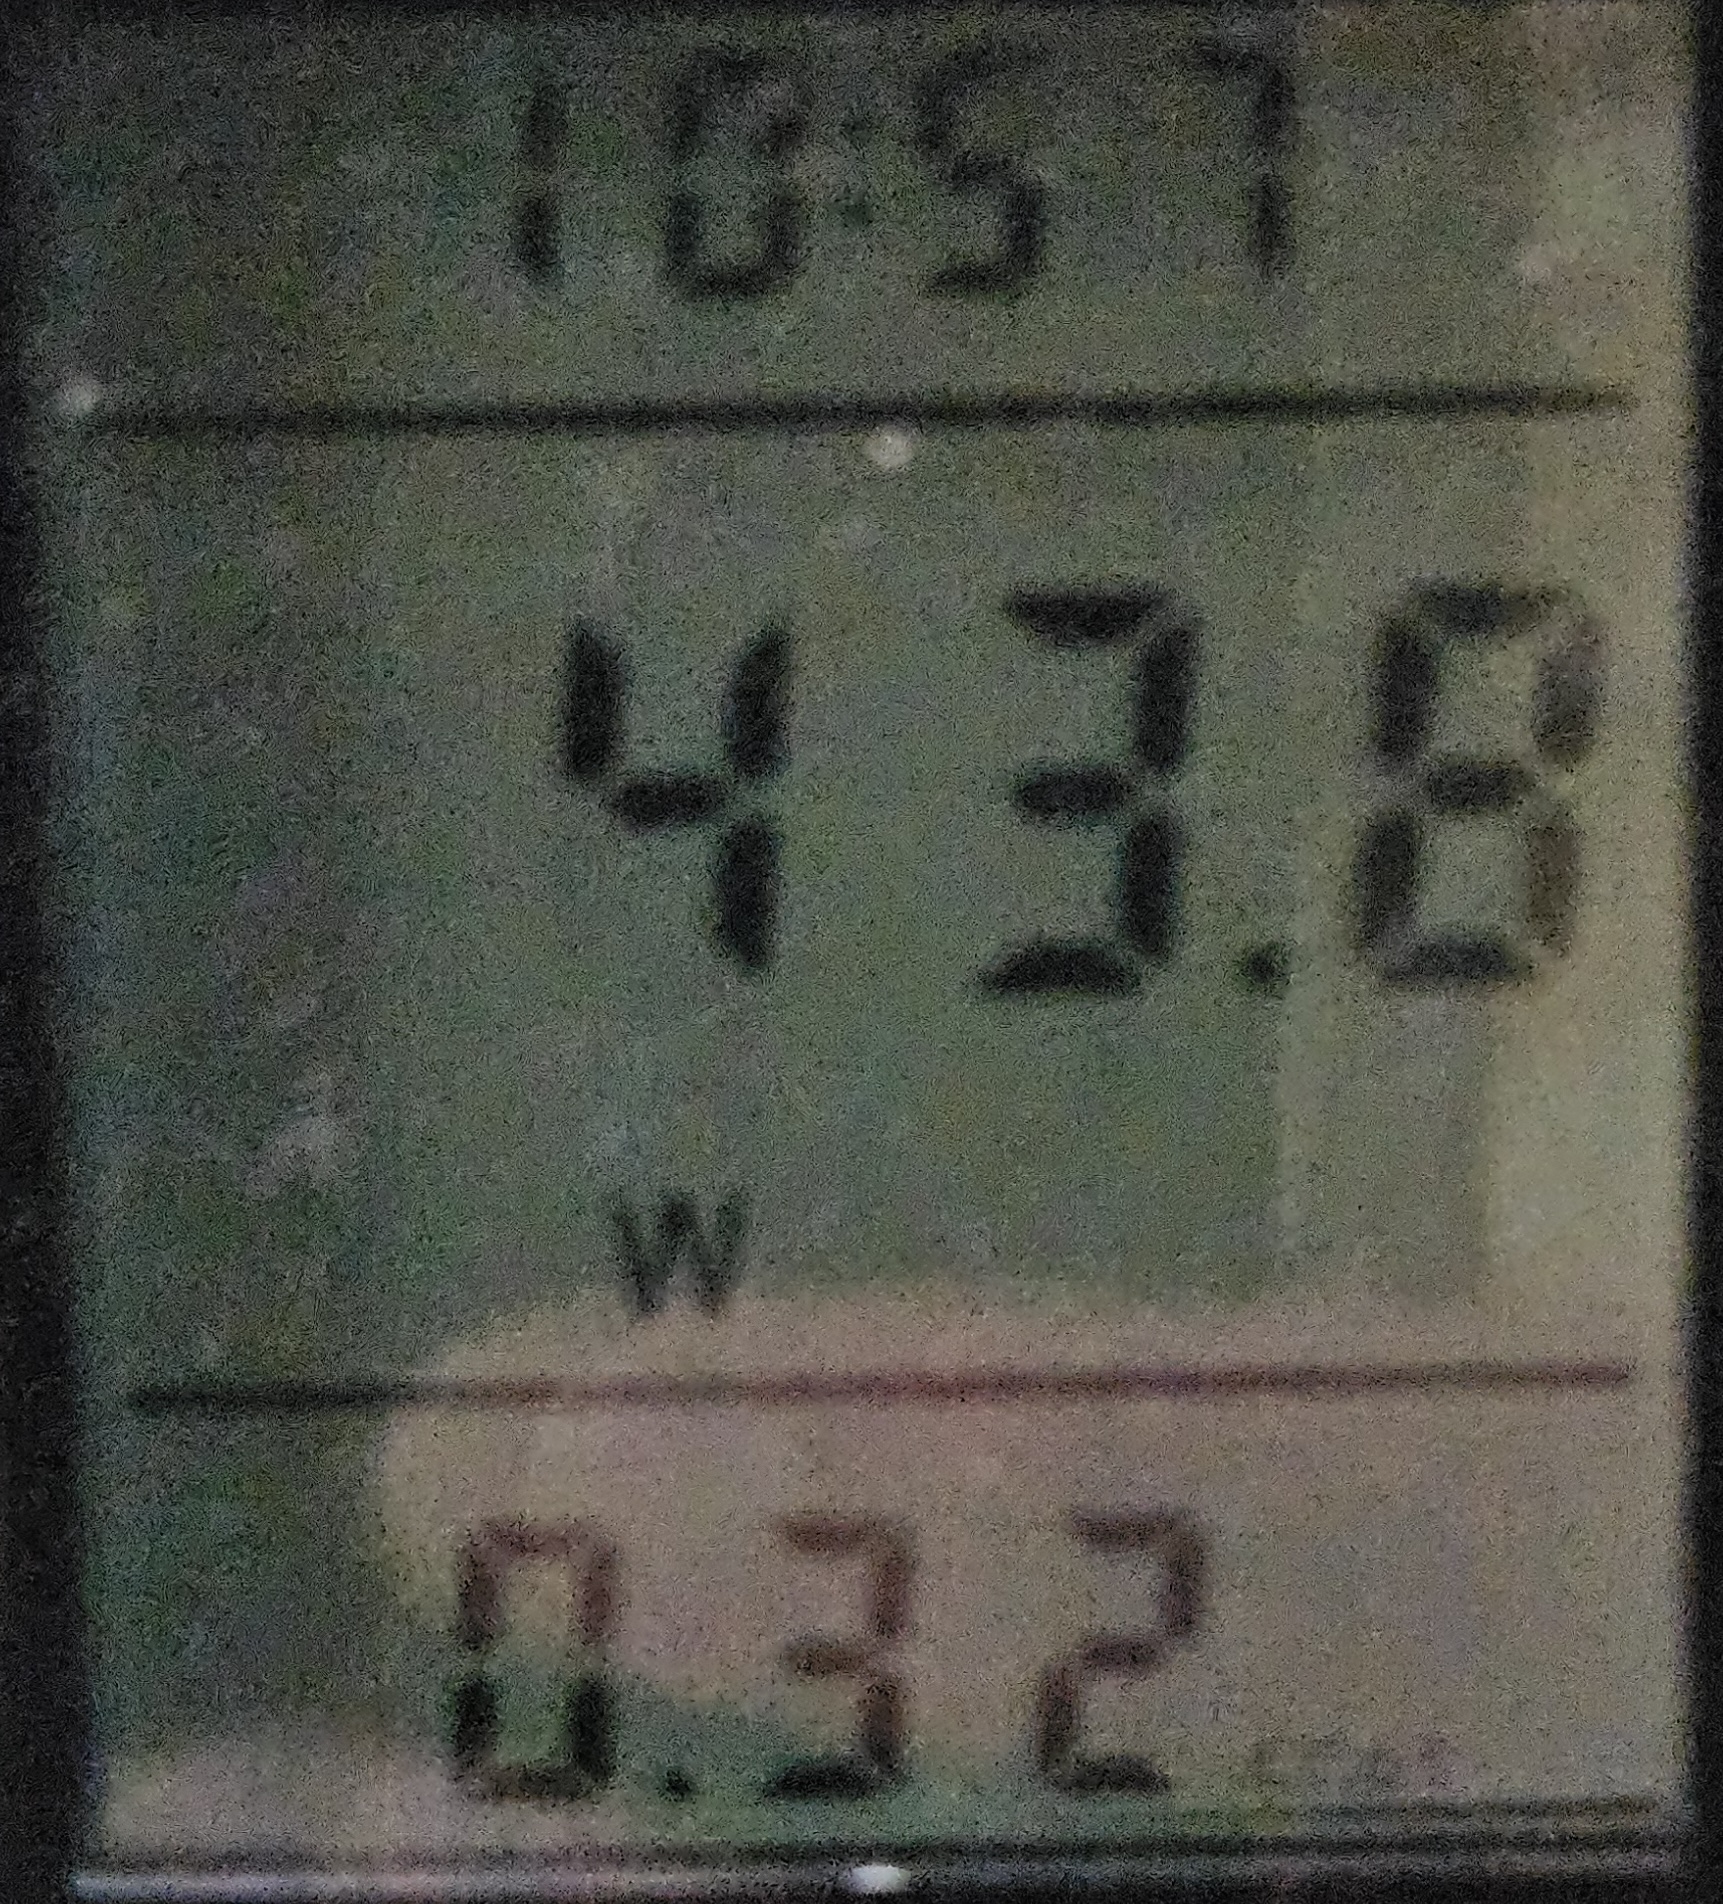
Sopra: Consumo a riposo intero sistema.
Il consumo dell’intero sistema in idle, misurato all’ingresso dell’alimentatore, risulta di 44W. Considerando che a livello BIOS sono stati attivati tutti i C-state della CPU, l’audio e il controller SATA Marvell 88SE9172 sono stati disabilitati, ritengo che in assoluto non sia un consumo basso per fare nulla. Magari il mio server principale (HP Elitedesk 800 mini G9), che consuma 6-8W in idle, mi ha abituato troppo bene!
Per chi non si accontenta, forse si può ottenere qualcosa in più spegnendo tutte le porte SATA (solo una è usata dall’SSD) e spegnendo la iGPU Intel rendendo così il sistema headless. Tuttavia, da un sistema del 2012(!) con RAM DDR3 non si possono chiedere miracoli.
Invece, il massimo consumo durante l’inferenza che ho osservato è di 294W. Non ho mai visto superare i 120W da ogni singola scheda, dunque si potrebbe limitare ulteriormente la potenza delle GPU fino a 140W senza penalizzare le prestazioni.
Costo del consumo#
Immaginiamo che il sistema sia sempre in idle e che le ore spese nell’inferenza siano trascurabili nell’ambiente casalingo. Consideriamo inoltre un costo al kWh di 0,25 € compreso di tasse, oneri e quant’altro. Otteniamo:
7,92€ al mese è la spesa minima di corrente necessaria per avere una AI locale con questa macchina. In presenza di un impianto fotovoltaico, mediamente il costo si dimezza nell’arco dell’anno. Il confronto con il mio abbonamento PRO di Anthropic è impietoso: 18€ al mese. Poco più del doppio per avere diversi ordini di grandezza di capacità in più! Ma se desiderate una AI locale, dovete andare oltre il mero conto economico.
Considerazioni finali e limiti#
Con 1239€ e un PC del 2012 ho ottenuto una macchina con 32GB di VRAM, in grado di ospitare Qwen3.8-27B in NVFP4 con una KV cache generosa e con consumi a riposo contenuti. Il compromesso, però, c’è e va detto chiaramente: il collo di bottiglia potenziale è il bus PCIe 3.0.
Le RTX 5060 Ti usano 8 lane PCIe 5.0, che corrispondono a circa 32 GB/s per direzione. Sulla GA-Z77X-UD3H le stesse 8 lane lavorano in PCIe 3.0: circa 8 GB/s, un quarto della banda per cui le schede sono state progettate.
Quanto pesa questa limitazione? Meno di quanto si possa pensare, ma esiste:
- Durante la generazione il modello e la KV cache risiedono interamente in VRAM, quindi la banda che conta è quella della memoria della GPU, non quella del bus.
- Il tensor parallel, invece, impone alle due GPU di scambiarsi i risultati intermedi a ogni layer. Le schede consumer non hanno NVLink, quindi questo traffico passa dal bus PCIe e anche dalla memoria della CPU (la libreria NCCL non usa la modalità P2P, ma SHM). Per ogni token generato i dati scambiati sono pochi e conta soprattutto la latenza. Durante il prefill di un prompt lungo, invece, i volumi crescono ed è lì che il PCIe 3.0 potrebbe farsi sentire.
- Il caricamento del modello è lento a causa dell’SSD mSATA (circa 550 MB/s): servono decine di secondi per leggere quasi 18GB. Succede però solo all’avvio del server di inferenza.
Avrei potuto evitare il problema con una piattaforma più moderna, ma avrei dovuto cambiare anche CPU e RAM, con una spesa ben diversa. Per un uso personale, in cui conta più avere un modello capace e un contesto ampio che la massima velocità, ritengo che il compromesso sia accettabile.
Le impressioni, però, contano poco: servono i numeri. Nel prossimo post, dedicato al software, metterò alla prova questa configurazione e vedremo quanto questi limiti pesino davvero sulle prestazioni.