Il software perfetto, come l’hardware perfetto, non esiste: dipende da cosa si vuole ottenere.
Privilegio stabilità e affidabilità e uso sempre software open-source o, nel caso degli LLM, modelli open-weights. Nell’AI tutto cambia a velocità vertiginosa: inseguire ogni novità è impossibile e anche poco utile, ma capita spesso di dover provare una nuova versione di qualcosa o di toccare un parametro delicato. Basta un niente e si rompe tutto, irrimediabilmente. Senza una rete di sicurezza robusta, il PC resta fuori uso finché non si trova il tempo per sistemarlo.
Il sistema operativo#
Proxmox è la mia scelta per il sistema operativo (OS) da dedicare al PC di inferenza. La possibilità di isolare specifiche applicazioni o servizi in container LXC o VM, insieme a snapshot e backup, mette ragionevolmente al riparo dai problemi che ho citato. Gli snapshot e i backup possono essere salvati in locale, sullo stesso disco su cui è installato Proxmox. Tuttavia, per una maggiore affidabilità, è opportuno utilizzare una share remota su un NAS o, meglio ancora, un servizio di backup dedicato come Proxmox Backup Server (PBS). Ho optato proprio per quest’ultima soluzione, creando una VM dedicata a PBS sul mio NAS Synology.
Proxmox è un sistema di una certa complessità e sono il primo a non usarne molte funzionalità avanzate. Ad esempio, ho disabilitato tutti i servizi di High Availability (HA): pur avendo più macchine con Proxmox, non uso il clustering e tanto meno l’HA. Per una panoramica pratica di come installare Proxmox sul vostro server AI, vi rimando alla guida di digitalspaceport.
Motori di inferenza#
Per l’inferenza esistono due tipologie di software:
orientati all’inferenza personale, cioè per un singolo utente. Llama.cpp e i suoi derivati ne sono l’esempio tipico.
orientati all’inferenza enterprise, tipicamente nei datacenter. Qui si privilegiano le prestazioni con molte richieste in parallelo. Il supporto hardware punta soprattutto alle GPU di fascia alta, dove NVIDIA è di casa. vLLM e SGLang sono le soluzioni di riferimento di questa categoria.
Ho adottato vLLM perché supporta nativamente la quantizzazione NVFP4 sulle GPU Blackwell e il tensor parallel su più GPU, e perché ha una comunità più estesa.
Per una questione di efficienza, vLLM gira all’interno di un container LXC (Debian 13) a cui è concesso l’accesso alle GPU del sistema. In questo modo l’accesso è più diretto, veloce ed economico: non ci sono strati software aggiuntivi come il kernel e i driver di una VM con il suo OS.
Per avviare il server di inferenza con il modello selezionato uso Docker, con un file docker-compose.yml per ogni modello o versione di modello che voglio provare.
Trovate il file docker-compose.yml da usare come template sul mio git.
LLM#
Come ho già raccontato in precedenza, il modello che ho adottato è Qwen3.8-27B. Preferisco un unico modello, molto capace per le sue dimensioni, con un contesto (KV cache) il più ampio possibile, utile per le sessioni degli agenti. Questo significa che anche le richieste più semplici invocano sempre un LLM che occupa tutte le risorse del sistema locale. Qwen3.8 gestisce image-to-text, video-to-text e text-to-text: restano quindi escluse la generazione di immagini, il text-to-audio e l’audio-to-text, a meno di implementarli via CPU.
In alternativa, si può adottare un approccio diverso e più sofisticato: un LLM compatto fa da router e smista le richieste a modelli con dimensioni, capacità e specializzazioni diverse. Questa soluzione, però, richiede risorse extra (GPU o NPU) che il mio hardware al momento non ha.
Poiché le due RTX 5060 Ti della macchina di inferenza sono di classe Blackwell, la quantizzazione di Qwen adottata è NVFP4. Esistono decine di quantizzazioni NVFP4 di questo modello e ne ho testate diverse, fra cui:
- nvidia/Qwen3.8-27B-NVFP4: 21.9 GB
- unsloth/Qwen3.8-27B-NVFP4: 23.4 GB
- gittensor-model-hub/Qwen3.8-27B-NVFP4-RTX5090: 17.9 GB
Non a caso ho riportato la dimensione di ogni modello. In media, una quantizzazione NVFP4 occupa più spazio di una INT4, e 22-24 GB iniziano a essere troppi per avere anche una KV cache generosa. Per questo ho scelto il modello di gittensor: per quanto sia stato pensato per una singola RTX 5090, funziona perfettamente in configurazione tensor parallel. Nella mia configurazione non posso sfruttare completamente i 32 GB di VRAM, perché su ogni GPU devono restare delle strutture dati per il contesto CUDA, i buffer NCCL e i CUDA Graph. Di conseguenza, non raggiungo i 262K token di KV cache, ma un rispettabile 237K.
Non scenderò nei dettagli di come Gittensor sia riuscito a ridurre la dimensione del modello in NVFP4 mantenendo una qualità pari (o superiore) a quella dei concorrenti, almeno stando ai benchmark. Su questo il mio approccio è pragmatico: un modello è efficace se porta a termine, in modo sistematico, i compiti che gli affido.
Hermes#
Ho adottato Hermes come piattaforma agentica locale. Online troverete innumerevoli risorse per l’installazione, la configurazione e l’utilizzo.
Per una questione di sicurezza, ho installato Hermes in una VM (Ubuntu 26.04.1 LTS) con un utente non sudoer. Oltre a Qwen3.8-27B locale, ho definito al suo interno un agente (o profilo) che ha accesso a Claude Code tramite il mio abbonamento Pro. Questa funzionalità è molto interessante perché consente ad Hermes di usare direttamente Claude Code, il programma da console, e quindi i modelli Anthropic senza passare dalle costose API.
Mettiamo tutto assieme#
flowchart TB
    subgraph HW["PC di inferenza: Intel i7-3770 + 2x RTX 5060 Ti 16 GB (Blackwell)"]
        subgraph PVE["Proxmox"]
            subgraph LXC["Container LXC: Debian 13 (accesso diretto alle GPU)"]
                subgraph DOCKER["Docker (un docker-compose.yml per modello)"]
                    VLLM["vLLM
tensor parallel su 2 GPU"]
                    LLM["Qwen3.8-27B NVFP4 (gittensor, 17.9 GB)
KV cache: 237K token"]
                    VLLM --- LLM
                end
            end
            subgraph VM["VM: Ubuntu 26.04.1 LTS (utente non sudoer)"]
                HERMES["Hermes
piattaforma agentica"]
                CC["Claude Code"]
                HERMES -- "profilo Claude" --> CC
            end
        end
    end

    HERMES -- "profilo locale
(API vLLM)" --> VLLM
    CC -- "abbonamento Pro" --> ANT["Modelli Anthropic
(cloud)"]

    subgraph NAS["NAS Synology"]
        PBS["VM Proxmox Backup Server"]
    end
    PVE -. "snapshot e backup
di LXC e VM" .-> PBS
Lo schema presenta l’architettura generale del sistema e riassume l’hardware e il software coinvolti.
Testiamo il modello#
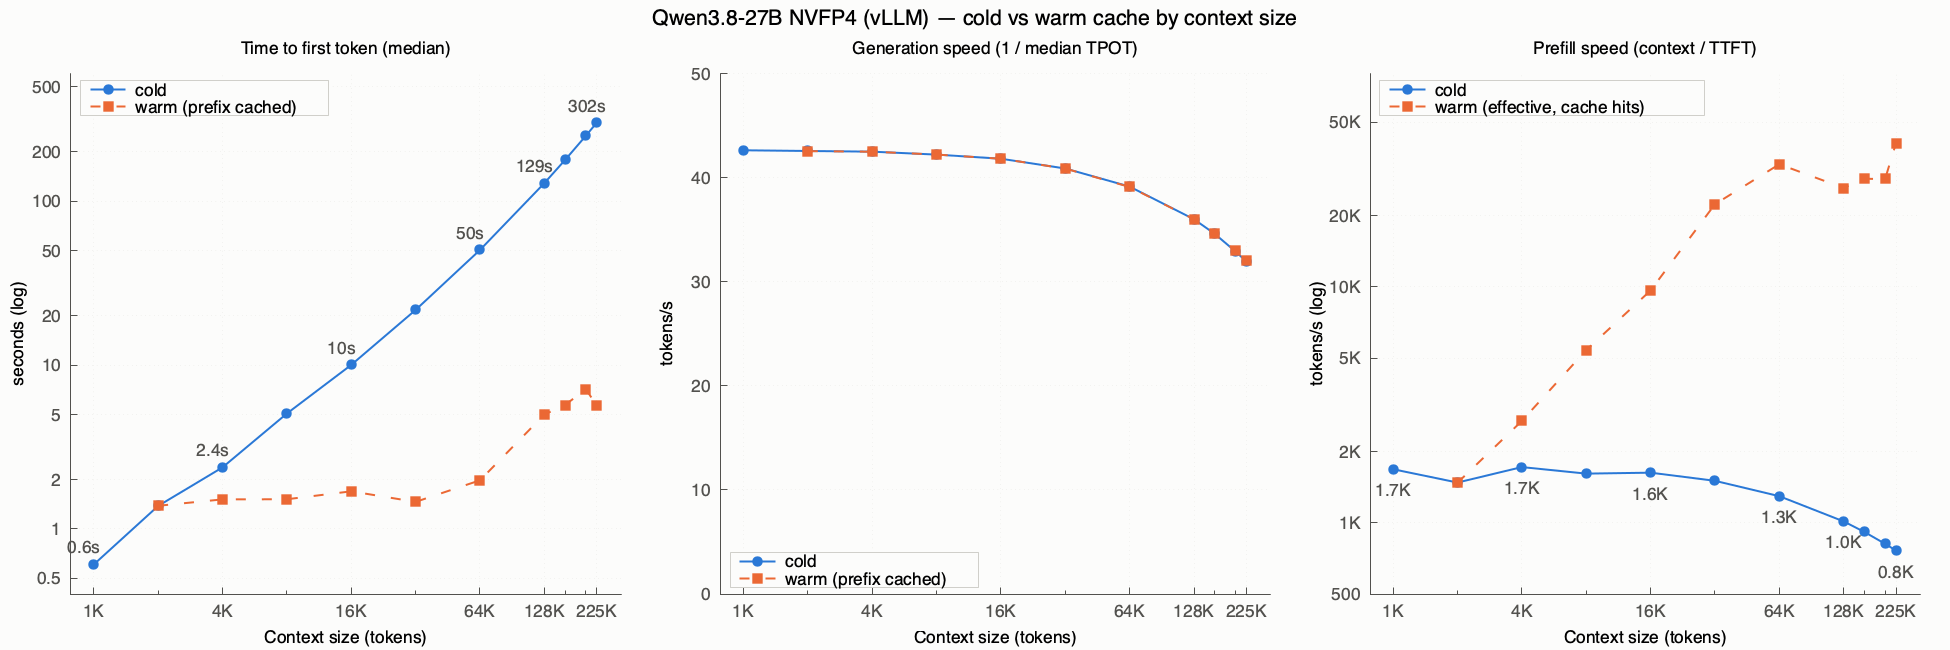
Finalmente, dopo tante chiacchiere, vediamo un po’ di numeri. Ho distinto due casi estremi:
- cold: ogni prompt è diverso, quindi il prefill viene rieseguito completamente e il prefix caching di vLLM non aiuta. Simula richieste del tutto indipendenti, cioè il caso peggiore.
- warm: tutte le richieste condividono il prefisso e cambia solo un suffisso di S token (S = 1K). Simula il turno di un agente, con il risultato di un tool e un nuovo messaggio.
I parametri di interesse sono tre:
- Time to first token (TTFT): il tempo mediano necessario a generare il primo token.
- Generation speed: i token generati al secondo (1000 diviso il tempo mediano per token, in ms).
- Prefill speed: la dimensione del contesto divisa per il TTFT. Nel caso warm è una velocità effettiva, perché gran parte del prompt è già in cache.
Ognuno ha un grafico dedicato, con le misure al crescere del contesto da 1K a 225K token (nel caso warm, da 2K). Trovate il mio script di test sempre sul mio git.
Cosa dicono i numeri#
Il prefix caching fa tutta la differenza. Nel caso cold il TTFT cresce con il contesto, e oltre i 64K anche più che in proporzione: 0,6 secondi a 1K, 10 secondi a 16K, 50 secondi a 64K, oltre due minuti a 128K e circa 5 minuti a 225K. Nel caso warm, invece, il primo token arriva in meno di 2 secondi fino a 64K e in 5-7 secondi anche con i contesti più lunghi. È questo che rende utilizzabili le sessioni agentiche: a ogni turno il modello rielabora solo la parte nuova, non l’intera conversazione.
La generazione cala dolcemente. La velocità resta intorno ai 42 token al secondo fino a 8K, scende a circa 39 a 64K e a 32 a 225K: a ogni token generato il modello deve consultare una KV cache sempre più grande. Cold e warm sono praticamente identici, come ci si aspetta: la cache accelera la lettura del prompt, non la scrittura della risposta.
Il prefill a freddo è il vero collo di bottiglia. Senza cache, le due RTX 5060 Ti elaborano circa 1.500-1.700 token al secondo fino a 32K; poi la velocità cala a 1.300 a 64K, 1.000 a 128K e circa 800 a 225K. Nel caso warm la velocità effettiva sale fino a 25.000-40.000 token al secondo, ma non è un miracolo dell’hardware: semplicemente, quasi tutto il prompt è già in cache.
In pratica: incollare da zero un documento lungo costa caro, ma una conversazione che cresce un turno alla volta resta fluida anche con centinaia di migliaia di token di contesto. Conviene quindi evitare tutto ciò che invalida la cache, come modificare il system prompt o l’elenco dei tool a metà sessione.
Considerazioni finali#
Proxmox, vLLM e Hermes formano uno stack forse non banale da mettere in piedi, ma solido: ogni componente è isolato, salvato con snapshot e backup e sostituibile senza rischiare di compromettere il resto del sistema. Posso provare un nuovo modello o una nuova versione di vLLM sapendo che, se qualcosa va storto, tornare indietro è questione di minuti.
Sul fronte delle prestazioni, un modello da 27B su due GPU di fascia media genera fra 32 e 42 token al secondo e, grazie al prefix caching, risponde in pochi secondi anche con contesti oltre i 200K token. Per un uso personale e agentico è un risultato più che soddisfacente, soprattutto considerando il costo e le limitazioni dell’hardware.