Lo ammetto, io odio le “scartoffie” e credo che molti di voi saranno dello stesso avviso. Tuttavia, dobbiamo conviverci: contratti, fatture, bollette e documenti di ogni tipo fanno parte della vita reale.
Di sicuro qui l’AI può venirci incontro: i documenti sono essenzialmente testo e gli LLM sono piuttosto abili nel trattamento del testo. Lo saranno anche i modelli locali? Lo scopriremo presto.
Il risultato, subito#
Prima di raccontare come ci sono arrivato, ecco cosa ottengo oggi. Scrivo una domanda su Telegram al mio agente e ricevo la risposta in pochi secondi, con tanto di fonti (informazioni personali e/o confidenziali sono state oscurate):
User:
in which room Anna ***** was and in which year?
How much was her rent? check the affitti wiki .

Assistant:
Done — answer from the wiki (log entry appended):

Anna *****, at via ** **********, **, in 2019–2020 (contract
01/10/2019–30/09/2020, terminated early by mutual agreement on
30/06/2020).

Room: no individual room — her contract was for the entire
apartment, let jointly (in solido) to five students (A, B,
C, D, E). Per-room ("stanza") contracts only began from Nov
2020.
Rent: €****/month (€*****/year) for the whole apartment,
shared by the five; deposit €****.
Sources: [[tenant-anna]], [[lease-xx-xxxxxxxxx-2019]],
[[property-xx-xxxxxxxxx-xx]] (registered contract, Agenzia
Entrate 15/10/2019, cedolare secca).
Notate un dettaglio: la domanda partiva da un presupposto sbagliato (una “stanza” che non esisteva) e l’agente lo ha corretto, spiegando da quando sono iniziati i contratti per camera. Trovare la stessa informazione a mano avrebbe significato aprire un PDF dopo l’altro.
Il problema#
Mi sono dedicato alla gestione dei contratti di affitto di alcuni appartamenti che impegnano una considerevole quantità di tempo da parte della mia famiglia, specialmente mia moglie. Uno di questi appartamenti in particolare, locato a studenti, genera la maggior parte delle scartoffie: infatti, esiste un contratto per camera. Si sa, gli studenti vanno e vengono, in continuazione ci sono disdette, nuovi contratti, rinnovi e con 4 camere la generazione di scartoffie è notevole così come il ricordarsi delle varie scadenze.
Quello che voglio ottenere è un sistema che quando vengono aggiunti i documenti che ho citato costruisca e aggiorni una base di conoscenza e che possa essere interrogata. Non si tratta di un database nel senso tradizionale, ma di qualcosa di simile ad un approccio Retrieval-augmented generation (RAG) senza la necessità/complessità dovuta all’embedding.
A. Karpathy, uno dei più influenti ricercatori del settore, ha proposto il pattern della llm-wiki. Invece di recuperare documenti a ogni domanda come nel RAG tradizionale, è l’LLM stesso a costruire e mantenere una knowledge base in markdown, persistente e che si arricchisce nel tempo. In pratica si mettono le fonti grezze in una cartella e il modello scrive ed indicizza un wiki che poi si può interrogare, producendo riassunti delle fonti, voci sui concetti, articoli e backlink. Anche gli output come slide, grafici e risposte vengono archiviati nel wiki come nuovi articoli, così la conoscenza si accumula invece di ripartire da zero a ogni sessione.
Cosa ho fatto#
Lo dico subito candidamente: non ho inventato nulla, ho semplicemente collegato degli elementi fra loro.
Il cuore del sistema è Hermes, la piattaforma agentica che gira in una VM dedicata sul mio PC per l’AI locale e che usa Qwen3.8-27B come modello; ho descritto tutto lo stack nel post precedente.
I documenti in PDF vengono prima archiviati nel mio Nextcloud. Ogni 6 ore, un cron job sulla VM di Hermes copia quella cartella nella cartella ‘affitti/’ nella home dell’utente:
# cloning affitti folder:
0 */6 * * * rclone copy remote-cloud:"<Nextcloud_path>" ~/affitti
Hermes dispone di una skill ’llm-wiki’ pronta all’uso. Ho aperto una sessione di chat e ho iniziato a chiedere a Hermes di fare quello che desidero. Riporto alcuni estratti della chat; le informazioni personali e/o confidenziali sono state oscurate.
Basta una riga per creare la struttura della wiki:
User:
vai nella cartella 'affitti/' e crea una llm-wiki.

Assistant:
Done. Initialized the llm-wiki at /home/hermes/affitti:

affitti/
├── SCHEMA.md        # domain: rentals — contracts, tenants, landlords, market data
├── index.md         # sectioned catalog (currently 0 pages)
├── log.md           # init entry logged
├── raw/{articles,papers,transcripts,assets}/
├── entities/        # properties, tenants, landlords
├── concepts/        # lease terms, rent increases, maintenance rules, utilities
├── comparisons/     # e.g. rent levels across properties
└── queries/
Poi ho chiesto di collegare i PDF alla wiki tramite link simbolici, senza copiarli, e di non iniziare subito l’importazione. La parte interessante è come ha risposto: prima di darmi un parere è andato a guardare com’erano organizzate le cartelle e ha capito da solo che si trattava di una cartella sincronizzata, in cui non deve mai scrivere.
Assistant:
Good question. Let me look at the actual nextcloud layout before I commit
to a recommendation.

`Appartamento XYZ` — via *******, 4 PDFs (contract, registration, 2
proroghe)
`Appartamento ABC` — via *******, ~50 PDFs organized by year
(affitto 2017 … affitto 2026)
There's also a .sync_*.db file, confirming this is a managed sync dir
— so we must never write into it.

My recommendation: yes, symlinks are the right solution — better than
copying:
[...]
Read-only stays read-only. [...] anything written into the nextcloud
folder (including a symlink created inside it) could be picked up by
the sync client and re-uploaded. So the links go in the wiki, never
in nextcloud.
Ha creato i link, ha aggiunto la regola in SCHEMA.md e solo allora ha aspettato il mio via. Ho iniziato con l’appartamento più piccolo:
User:
start with 'Appartamento XYZ'

Assistant:
****** ingested. All 4 PDFs were read through the symlink (none
copied/modified); the main contract's body is a scanned image with
no text layer, but page 1 (asseverazione) plus the 3 Entrate receipts
contained all the key data.

Created 7 pages: [...]

Open questions (flagged on the pages, worth answering when you see
the signed proroghe):

Did the rent change at the proroghe? The receipts don't restate it
— assumed still €***.
Which landlord opted for cedolare secca, and does it carry to the
proroghe?
2+1 renewal/proroga rules and deadlines — the receipts don't contain
them.
Le “open questions” sono la cosa che ho apprezzato di più: invece di inventare ciò che nei documenti non c’è, l’agente lo dichiara e lo segnala nelle pagine. Ho risposto alle prime due domande e le pagine della wiki sono state aggiornate citando la mia conferma come fonte.
Di default, la skill genera testo in inglese; bisogna dire ad Hermes che tutti i documenti vanno redatti in italiano: sorry not to have mentioned before, but the wiki text must be in Italian as the input documents.
Ho continuato così fino a fargli digerire tutti i documenti disponibili in quel momento: 60 PDF trasformati in 54 pagine wiki, in circa 4 ore.
Renderlo automatico#
Voglio che regolarmente Hermes controlli se ci sono nuovi documenti ed aggiorni di conseguenza la wiki. Inoltre, voglio che vengano fatti dei controlli affinché tutto il sapere sia consistente (funzionalità di lint o health-check tipica della llm-wiki). Eventuali aggiornamenti o inconsistenze devono essermi segnalati, via Telegram, perché possa prenderne subito visione ed intervenire.
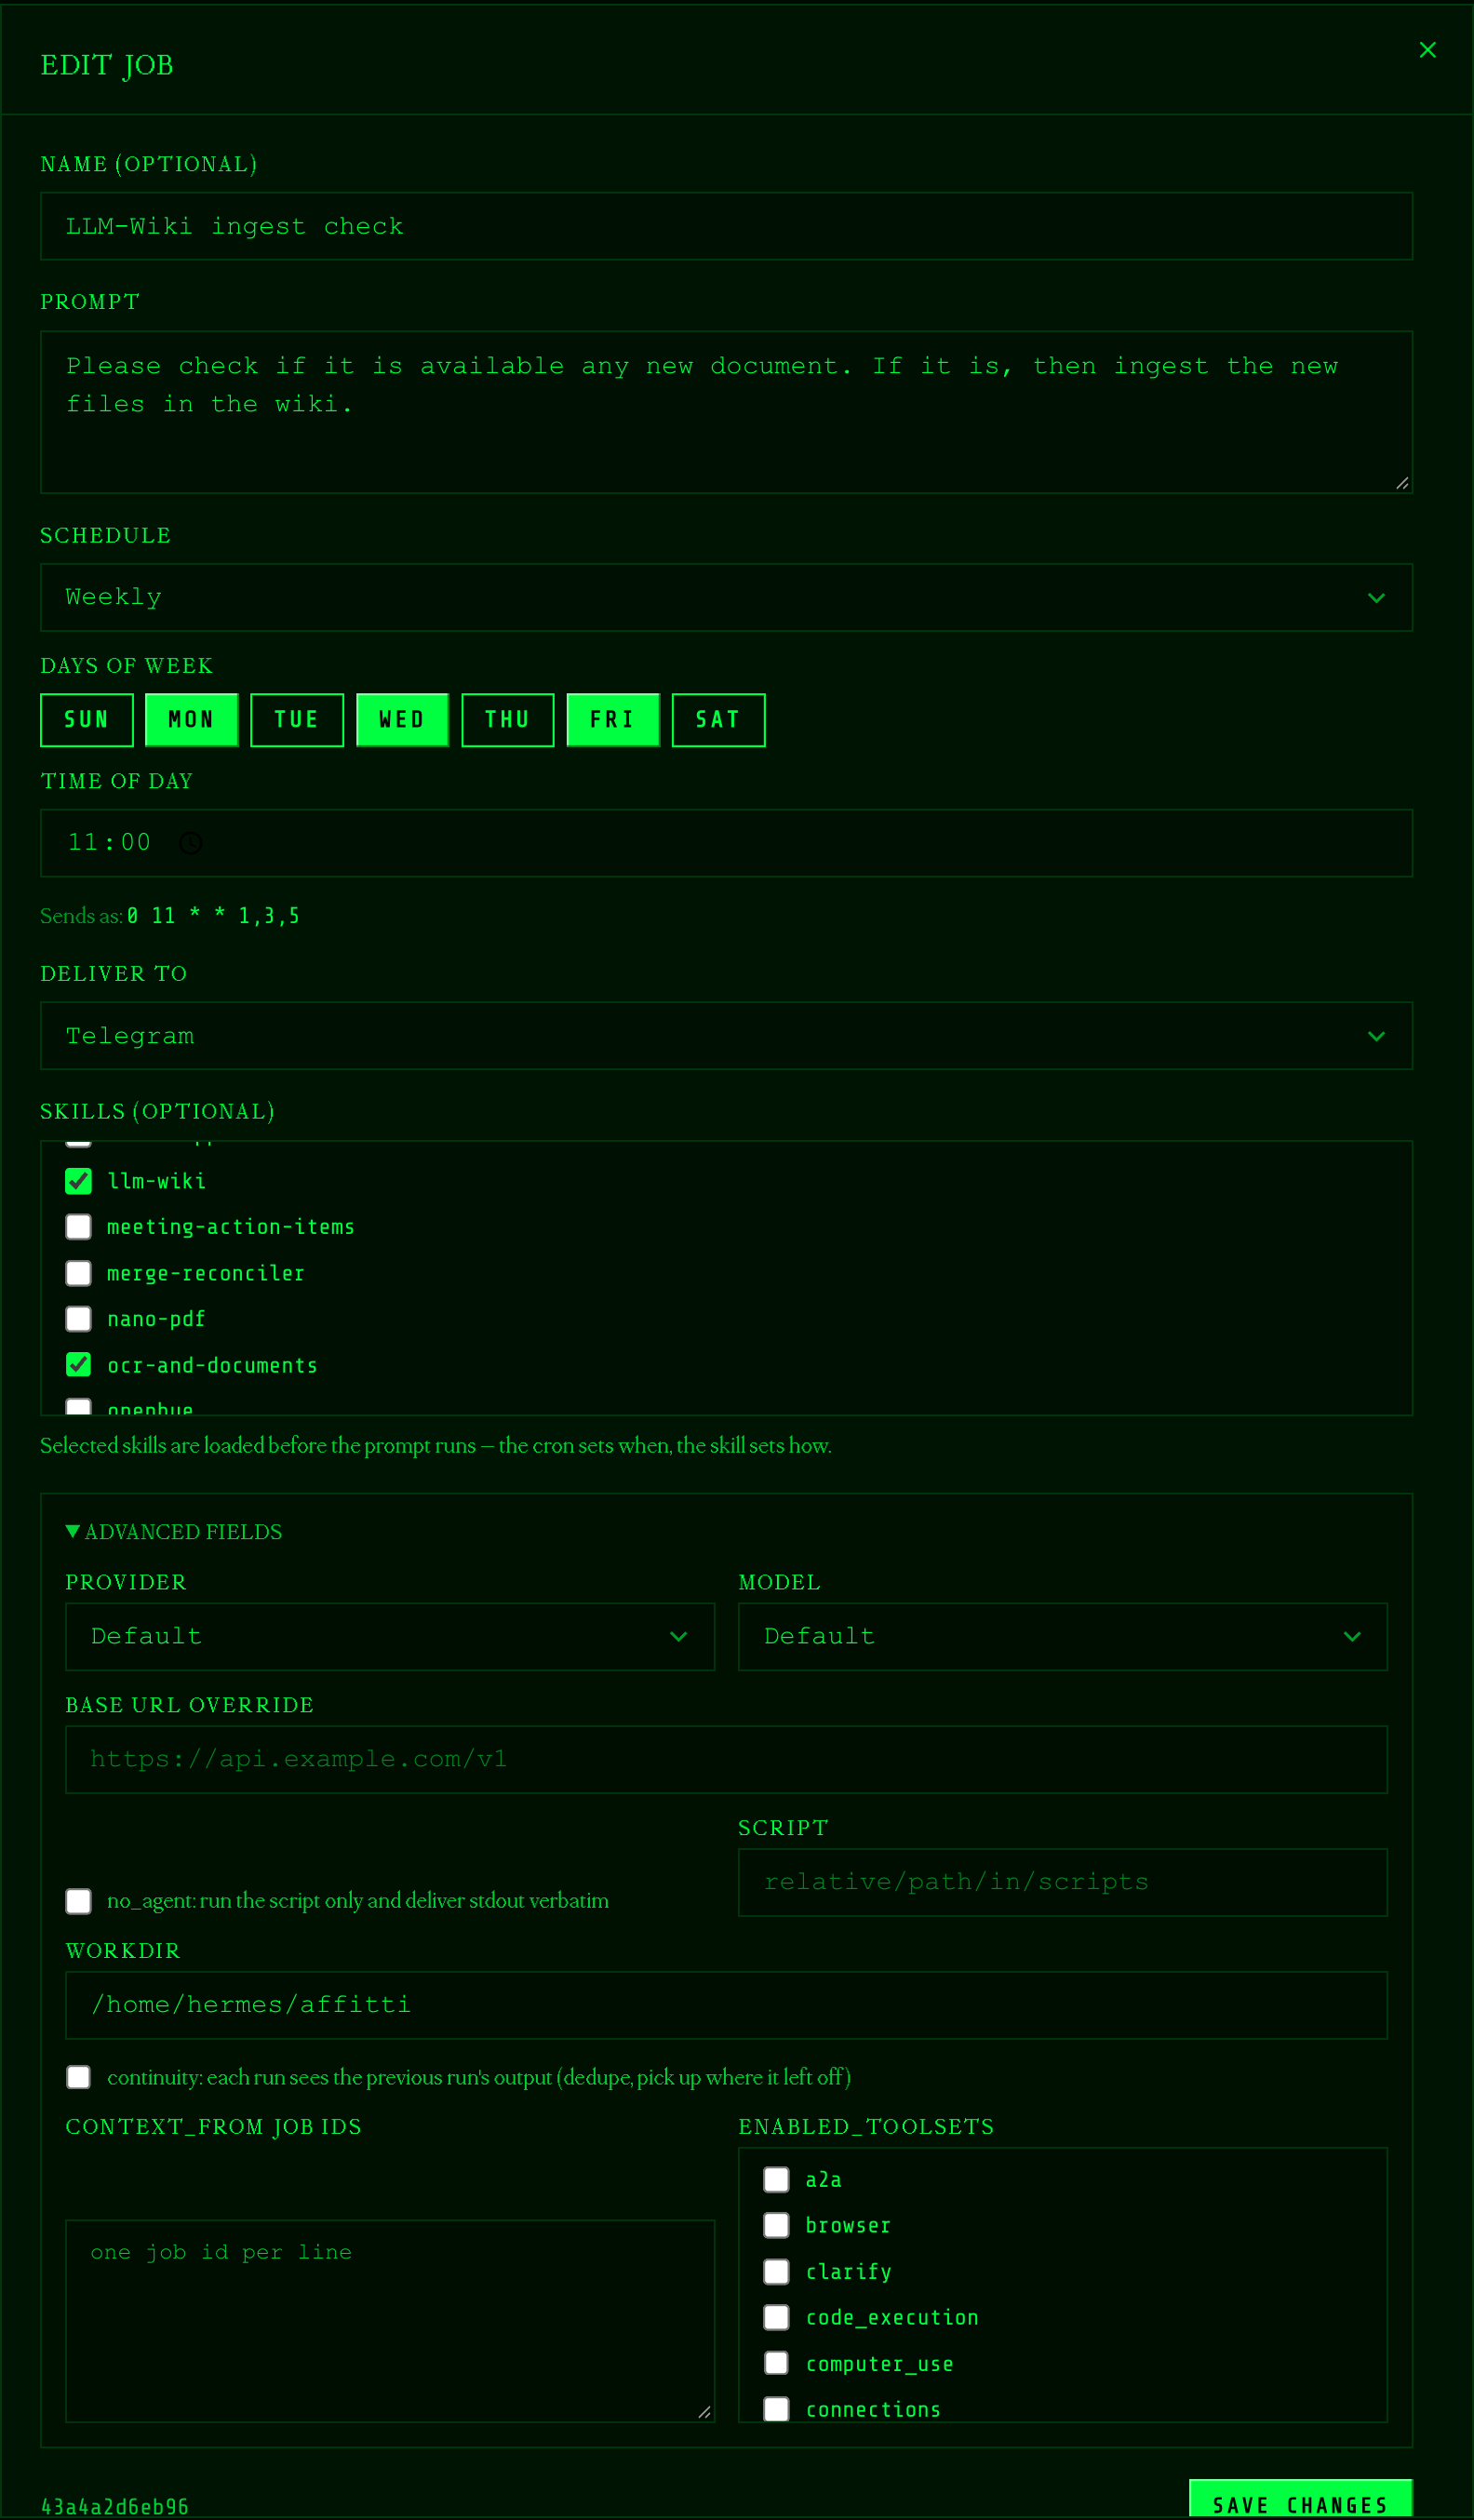
Di nuovo ho usato il cron, ma non quello di sistema (Unix). Hermes dispone di un sottosistema cron gestito in autonomia. In figura potete vedere il prompt con cui viene invocato l’agente di default, i giorni e l’orario di attivazione, le skill da includere e la cartella dove l’agente avrà accesso. Seguendo lo stesso principio, ho realizzato un secondo cron che gira al sabato mattina per il lint della wiki.
Perché scrivo le istruzioni in inglese? Prompt, skill e istruzioni per l’agente li scrivo quasi sempre in inglese, per due buoni motivi:
- la maggioranza del testo usato per allenare un modello è in inglese (o in cinese!), dunque mi aspetto che risponda meglio in questa lingua;
- l’inglese è di solito più diretto e conciso dell’italiano, quindi si risparmiano token che le GPU dovrebbero elaborare inutilmente, con un guadagno anche in tempo.
Come si usa?#
Karpathy, nel suo template originale, utilizzava Obsidian per navigare la wiki. In realtà, si può usare qualunque cosa in grado di leggere file markdown.
Io invece ho un altro approccio: non visualizzo la wiki, ma utilizzo esclusivamente la chat con l’agente, principalmente via Telegram. Quando ho bisogno di qualcosa, lo chiedo direttamente, come nell’esempio che avete visto all’inizio.
Limiti e miglioramenti#
Usando documenti markdown, la scalabilità dell’approccio llm-wiki classico è limitata. Realisticamente, fino a ~100 file sorgenti e centinaia di pagine wiki le prestazioni sono buone anche con un LLM locale di modeste dimensioni come Qwen3.8-27B, che è proprio quello che uso. Ecco quindi la risposta alla domanda iniziale: sì, per questo compito un modello locale è più che adeguato. Oltre quella soglia, bisogna affidarsi a qualcosa di meglio di un file di indice.
Conclusioni#
Per il mio caso specifico, la wiki è più che sufficiente. Non devo più rovistare tra cartelle di PDF per ritrovare una data, un importo o il nome di un inquilino di qualche anno fa: lo chiedo su Telegram e la risposta arriva in pochi secondi, con le fonti. E quando una scadenza si avvicina o un nuovo documento non torna con il resto, è Hermes a ricordarmelo ogni sabato mattina.
Le scartoffie continuo a odiarle, ma almeno adesso se ne occupa qualcun altro.